Kontynuujmy zatem zaczęty w poprzednim wpisie wątek stabilności testowych wyników mechanicznych systemów tradingowych.
TEST 2. PRZEWAGA W DZIAŁANIU
Nazwa nie oddaje dokładnie tego co weryfikuje w kolejnej próbie autor gdyż w zasadzie celem eksperymentu była relacja wyników w teście na nowych danych (out-of-sample) do wyników uzyskanych przy budowie systemu (in-sample).
Warunki brzegowe testu podobne jak poprzednim razem:
– za pomocą programu „Kantu” autor generuje 5 000 systemów transakcyjnych opartych na zależnościach między cenami,
– do tego celu używa dziennych kursów historycznych (OHCL) pary EUR/USD za okres styczeń 1986- sierpień 2012
– zakres danych in-sample (użytych do budowy systemu) obejmował stopniowo od 500 do 5000 dni (co 500)
– zakres danych weryfikacyjnych czyli out-of-sample (nie widzianych przez system przy jego tworzeniu) obejmował stopniowo od 200 do 800 dni
Tym razem zadanie polegało na wykryciu szans uzyskania przez wyprodukowane systemy wyników wyższych na nieznanych im danych niż te wygenerowane przy budowie. Innymi słowy: jaki procent stworzonych systemów jest w stanie uzyskać wyższy wynik na niewidzianych danych niż na tych, do których dopasowano je w procesie konstrukcji.
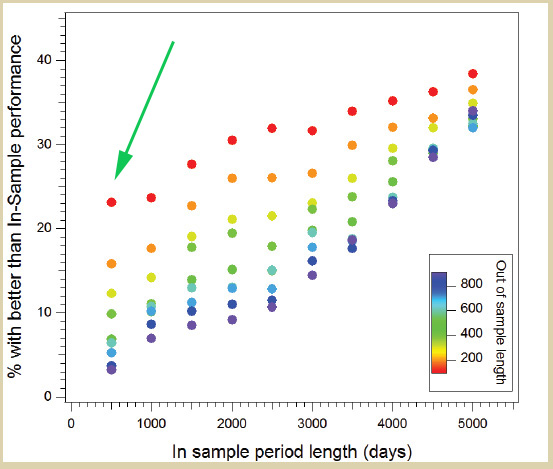
Miarą w tym wypadku jest zysk na transakcję co pozwala w pewien sposób ujednolicić porównania. Poniższy diagram zaczerpnięty z artykułu pokazuje uzyskane rezultaty:
Żródło: Currency Trader sierpień 2013
Na skali poziomej mamy jak poprzednio ilość dni użytych w danych in-sample (czyli tych do zbudowania systemu). Do testowania za każdym razem pobierano ich o 500 więcej.
Skala pionowa pokazuje ile procent w każdej kategorii testów na danych out-of-sample (nie widzianych wcześniej) zysk na transakcję był WYŻSZY niż przy budowie systemów.
Poszczególnymi kolorami oznaczono dla orientacji zbiory danych out-of-sample.
I tak np. wskazana przez mnie strzałką kropka oznacza, że spośród 5000 systemów ułożonych na podstawie danych z 500 dni, około 23% z nich uzyskało lepszy wynik przy puszczeniu ich na zbiorze kolejnych 200 dni.
Jak widać po kolorach zależność jest niemal liniowa, rezultaty układają się w pewien wzorzec.
Szybkie wnioski:
1. Im dłuższy okres danych nie widzianych przy budowie a wziętych do weryfikacji systemu (out-of-sample) tym niższy odsetek wyników lepszych niż w procesie konstrukcji. Dlatego kropki granatowe (800 dni) są najniżej, a czerwone (200 dni) najwyżej przez całą szerokość wykresu. Logicznie rzecz analizując należałoby więc przyjąć do wiadomości, że w dłuższych okresach out-of-sample mamy większą szansę wpaść na okresy obsunięcia kapitału (drawdown).
2. To normalne zjawisko, że system puszczony na nowych danych nie osiąga takich wyników jak przy jego produkcji, podczas której każdy rodzaj optymalizacji dopasowuje parametry do tego co było w historii. W rezultacie tylko od 3 do 37% z nich udaje się pobić wyniki uzyskane przy budowie (te procenty wynikają z zakresu widocznego na wykresie powyższym).
3. Im większy zakres danych użytych do budowy systemu tym wyniki testów out-of-sample skupiają się koło siebie (kropki w pionie wzajemnie coraz bliżej). Zmniejsza się tym samym margines potencjalnie błędnych wniosków wyciągniętych z procesu budowy systemów.
4. Ponownie przewaga statystyczna (wartość oczekiwana) systemów wychodzi solidnie dopiero wówczas gdy do obu testów (in-sample i out-of-sample) użyjemy jak najszerszych zakresów danych. Widać to po coraz wyżej położonych kropkach gdy przesuwamy się w prawo po wykresie.
Nadal jednak trzeba mieć z tyłu głowy informację, że w tego rodzaju systemach więcej niż połowie z nich nie udaje się przewyższyć średniej zyskowności na transakcję uzyskanej podczas budowy. I dlatego też zwykle przyjmuje się, że rzeczywisty zysk w realu może być o połowę niższy niż podczas konstrukcji systemu.
CDN
—kat—