
Na ile zakres danych użytych w testach ma wpływ na efektywność systemu transakcyjnego? Temu mam zamiar przyglądnąć się niżej.
Źródłem będzie tym razem artykuł zaczerpnięty z sierpniowego numeru „Currency Trader”, autorstwa Daniela Fernandeza, który dość regularnie publikuje tam pomysły na strategie/systemy oraz dzieli się swoją wiedzą na temat efektywności mechanicznego podejścia. Niezwykle inspirujący i wart prezentacji wydał mi się problem znaczenia okresów testowych, solidnie statystycznie i wizualnie udokumentowany przez niego i zamieszczony pod tytułem „FX trading system development: Outperforming your test”.
Zacznę jednak od tego, że w prezentowanych testach użył on stworzonego przez siebie programu o nazwie „Kantu”, który służy do mechanicznej budowy lub może raczej wykrywania systemów transakcyjnych. Fernandez nie robi jednak przy tym żadnej nachalnej reklamy więc i ja bym nie chciał, ale dla zrozumienia tematu potrzebne jest mini wprowadzenie w tym zakresie.
Otóż zadaniem „Kantu” (dość łatwo znaleźć go w wyszukiwarce) jest automatyczne tworzenie systemów opartych wyłącznie o układy cenowe, znalezione w załadowanych do niego danych. Po ustawieniu własnego zakresu udostępnionych software’owo kryteriów program przeszukuje dane, wykrywając powtarzające się w nich zależności pomiędzy cenami, tworząc na tej podstawie algorytmy dające się dalej testować na danych nie widzianych w testach i tworząc bazę potencjalnie najbardziej skutecznych rozwiązań do tradingu w sposób mechaniczny w przyszłości.
Przy okazji znalazłem darmowego e-booka stworzonego przez Fernandeza, a traktującego o tradingu systemowym na rynku forex (niestety tylko po angielsku). Muszę przyznać, że dość w przystępny sposób wyjaśnia tam problemy mogące powstawać podczas zabaw z systemami. Tym razem bez kozery podam adres, pod którym można go znaleźć:
http://entirely4you.com/free_ebook.pdf
I przy użyciu „Kantu” autor dokonuje testów oraz obudowuje je opisem trzech kategorii eksperymentów, w których pokazuje zależności pomiędzy okresem danych użytych do budowy systemu (tzw. in-sample) i danych sprawdzających skuteczność, które nie były widziane podczas budowania (tzw. out-of-sample).
Założenia początkowe wyglądały we wszystkich trzech przypadkach jednakowo:
1. Dane dzienne pary EUR/USD zostały użyte, okres styczeń 1986- sierpień 2012
2. Zakres danych in-sample obejmował stopniowo od 500 do 5000 dni
3. Zakres danych out-of-sample obejmował stopniowo od 200 do 800 dni
4. W teście in-sample generowane zostało za każdym razem 5 000 systemów opartych na zależnościach cenowych, których wyniki były dodatnie a dla których współczynnik determinacji (R2) wyniósł 0,9.
Przykładowy, pojedynczy test wyglądał następująco:
Dla danych in-sample z 2 000 dni (np. okres 1 sierpnia 2000 do 22 czerwca 2006) generowano 5 000 wspomnianych wyżej systemów, po czym sprawdzano ich działanie na kolejnej próbce danych out-of-sample z np. 200 dni (za okres 23 czerwca 2006 do 11 sierpnia 2006).
TEST 1. PRZEŻYWALNOŚĆ
Miał on odpowiedzieć na pytanie ile procent wygenerowanych systemów przeżyło zyskownie jeśli puszczono je na „nie widzianych” wcześniej przez nich danych. Inaczej rzecz ujmując: taka symulacja odpowiada na pytanie jaka szacunkowo część utworzonych systemów mechanicznych daje sobie teoretycznie radę w realnym tradingu. Wyniki pokazuje poniższy diagram zaczerpnięty z artykułu:
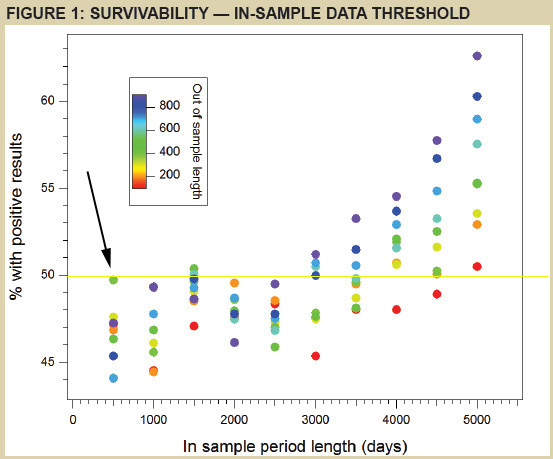
Żródło: Currency Trader sierpień 2013
Jak go czytać:
Na skali poziomej mamy ilość dni, użytych w danych in-sample (czyli tych do zbudowania systemu). Do testowania za każdym razem pobierano ich o 500 więcej.
Skala pionowa pokazuje odsetek tych, które przeżyły zyskownie próbę na nowych danych out-of-sample.
Poszczególnymi kolorami oznaczono dość płynnie właśnie zbiory danych out-of-sample.
I tak np. wskazana przez mnie strzałką zielona kropka oznacza, że spośród 5000 zyskownych systemów ułożonych na podstawie danych z 500 dni przeżyło średnio niecałe 50% z nich puszczone dla sprawdzenia na zbiorze ok. 400 kolejnych dni.
Ową granicę 50% zaznaczyłem na wykresie również – za pomocą poziomej, żółtej linii. Jak widać niemal wszystkie systemy układane na zbiorze danych obejmujących mniej niż 3000 dni nie przekroczyły owego poziomu. Co prowadzi do wniosku, że najwyżej co drugi z nich przeżywa test na danych nie widzianych przy jego konstrukcji. Mamy więc do czynienia z szansami nieco gorszymi niż na poziomie losowości (jak w rzucie monetą).
Szanse przeżycia rosną wraz z ilością dni użytych do budowy systemu. W najlepszym przypadku- czyli danych z 5000 dni – istnieje szansa, że niemal 65% z systemów przeżyje w teście na ”nie widzianych” wcześniej danych z 800 lub więcej dni (kropka granatowa położona najwyżej).
Co to oznacza?
Można wyciągnąć jakieś przybliżone wnioski, ale tylko odnośnie wszystkich systemów budowanych w oparciu jedynie o ceny (układy świecowe, kanały cenowe, klasyczne formacje techniczne, wsparcia/opory itp.). Im większy okres danych użytych do ich budowy tym szanse przeżycia większe. To oczywiste ponieważ system podczas tworzenia ma szansę „zobaczyć” wszelkiego rodzaje warunki rynkowe – hossy, bessy i flauty o różnych zmiennościach.
Po drugie – im testy na dłuższych ciągach danych nie widzianych przy budowie (out-of-sample) tym większa szansa, że system przeżyje (proszę zobaczyć to po kolorach kropek dla tych testów powyżej 3000 dni). Po prostu jeśli system posiada rzeczywistą przewagę statystyczną to łatwiej ją wykazać potem w dłuższym okresie na nowych danych. Okresy krótkie często łapać mogą bowiem w teście out-of-sample tylko obsunięcia systemu, okresy dłuższe uwzględniać powinny również warunki sprzyjające (tzw. run-ups).
CDN
—kat—



